
改 17 行参考解,六个并列第一的模型分出了 23 个点
MaxxBench 把 89 道 DeepSWE 编程题的平均参考解加长了 17 行(约 3.5%),原先挤在 74% 附近的六个模型立刻拉开 23 个百分点:DeepSeek V4.1 Flash 从 74.2 掉到 55.6,Claude Opus 5.5 反而升到 76.4。同样的题、同样的模型,分数却重排,说明榜单测到的很大一部分是「这道题我见过」,不是「这类活我会干」。这篇从这台实验讲起,把基准污染、照着评分脚本调优、自报指标、统计分辨率四件事拆开,最后给一套能自己执行的评测纪律。
本节你将能
读完能判断一张榜单值不值得信:看它用了多少题、题有没有泄出去、分数是谁报的、差几个点到底算不算差。你还能自己写出考场纪律——留出集怎么切、变体题怎么造、置信区间怎么算,以及为什么「我们内部 benchmark 提升 30%」这句话在采购决策里几乎没有信息量。
直觉模型:一张卷子,三种作弊方式
考试这件事有个前提:题不能提前给你。模型评测也一样,只是它的「提前看到」不太显眼。
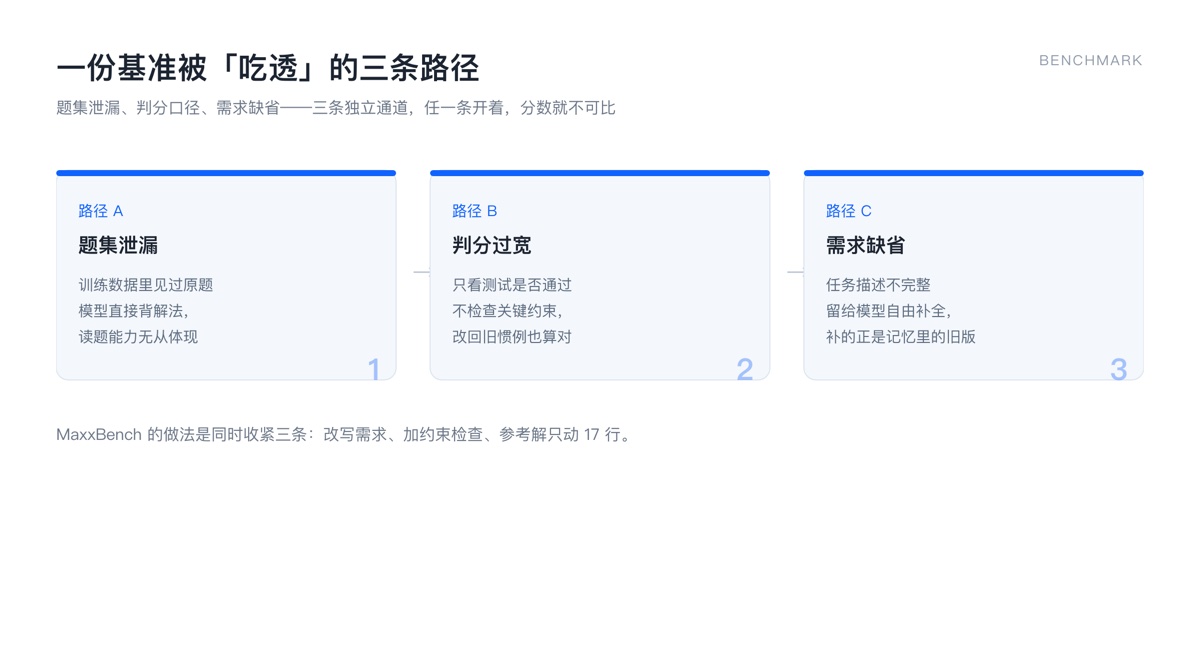
基准被「吃透」的三条路径:题集泄漏、判分过宽、需求缺省。
第一种是见过题。预训练语料动辄几万亿 token,GitHub 上的题解、题面、测试用例都可能在里头。模型没有背答案的动机,但它确实见过。这叫基准污染(benchmark contamination)。
第二种是照着评分规则练。评分脚本怎么判、测试怎么跑、哪几个用例必过,这些都能被反向利用。把 prompt 和 agent 支架一起调到「这个 benchmark 的判分口味」上,业内叫 benchmaxxing。分数涨了,泛化没动。
第三种是自己出卷自己判。厂商公布一个私有 benchmark,只开放结论不开放题集,外人无法复核。这不必然是造假,但它把验证成本转给了买家。
MaxxBench 针对的是第一种。做法很朴素:不换模型、不换评分脚本,只把题目的要求改一点。89 道 DeepSWE 题,说明文字或初始代码被改写,参考解中位数长了 17 行,大约 3.5%。改动小到像是同一个人第二天重写了一遍需求。
核心要点
- 分数位移的方向不一致,才是真相。Claude Opus 5.5 从 74.2 升到 76.4,DeepSeek V4.1 Flash 从 74.2 掉到 55.6,Gemini 3.8 Flash 从 73.8 掉到 53.4。同一批题上原来打平的两个模型,一个往上、一个往下掉了 18.6 分,说明它们强在不同的东西上:一个会读新要求,一个更依赖熟悉的题型。
- 「并列第一」可能是统计噪声。89 道题、74% 正确率,标准误是 个百分点,95% 置信区间大约 ±9 个点。也就是说六个模型挤在 1.5 个点以内这件事,本来就分不出高下;而改题后拉开 23 个点,才第一次让差异变得可测。
- 变体题的改动必须落在语义上,不能只换皮。把变量名从 foo 改成 bar 不算变体,那是同题。MaxxBench 改的是需求本身,比如文件名大小写、报告粒度。这类改动会改变实现路径,才会暴露「背过题」。
- 自报指标只能当线索,不能当证据。Qwen4-Max 发布时给出的单任务成本从 4.43 美元降到 1.67 美元,降幅 62%,依据是自家的 Work360 私有基准。数字可能完全真实,但它回答的是「在我们的题库上更省」,不是「在你的活上更省」。
算一遍就明白为什么很多榜单不该拿来排名次。、 时,,区间宽度接近 18 个百分点。想让 2 个点的差距有意义,题目数量得涨到几千道,或者用同一批题跑多次、配对比较。
案例锚点:两个「分数说了不算」的现场
第一个现场在 MaxxBench 的 Testem 任务里。原题要求给每个浏览器生成一份独立报告文件;变体题加了一条:文件名用小写,比如 chrome.xml 而不是 Chrome.xml。有一个 agent 正确实现了小写,随后去查了外部资料,发现「常见写法是大写」,于是把自己的正确实现改了回去。它不是在解题,是在回忆惯例。
第二个现场在数学形式化。Kevin Buzzard 复核了 OpenAI 约 290 个 Lean 定理文件,其中 38 个连论文的主定理都没有陈述,更谈不上证明。文件能编译、CI 是绿的、结论写着「已形式化验证」——四道关卡里只过了最浅的一道。他给出的检查顺序是:Lean 陈述与论文里的非形式陈述是否一致、代码能否编译、lake comparator 能否确认证明的正是那个陈述、再跑一次偏执模式的内核复核排除 Lean 自身被利用的可能。
两件事的共性:可验证性被当成了已验证。能跑、能编译、能出分,都只是必要条件。
互动:给一张榜单做体检
拿一张你正在参考的榜单,回答五个问题,任何一个答不上来就先别用它做决策:
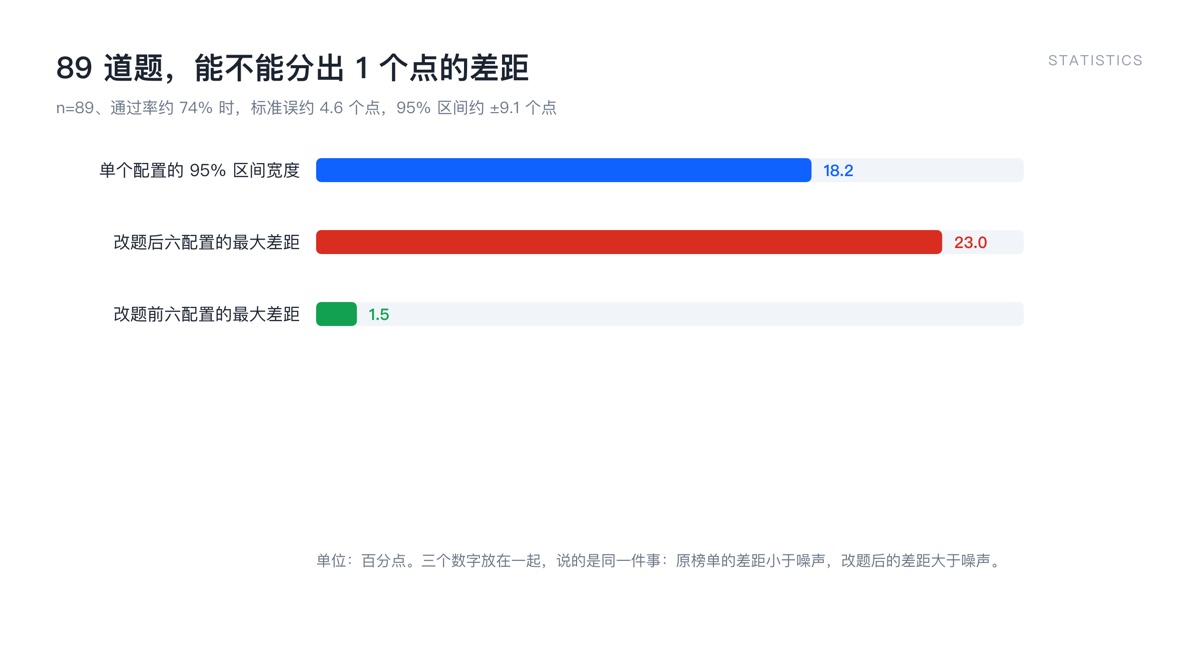
89 道题的分辨率:原榜单的差距小于噪声,改题后的差距大于噪声。
- 题目数量是多少?据此算一下 95% 置信区间宽度。
- 题集是否公开?有没有 held-out 集,还是训练和评测共用一份?
- 分数是谁跑的?厂商自报、第三方复现,还是你亲手跑的?
- 有没有变体题或扰动版本?改了什么,改的是语义还是表面?
- 评测的判分脚本是否公开?失败样本有没有一起公布?
import math

def ci95(p, n):
    """正态近似的 95% 置信区间半宽,单位:百分点"""
    se = math.sqrt(p * (1 - p) / n)
    return 1.96 * se * 100

print(f"n=89, p=0.742 -> ±{ci95(0.742, 89):.1f} 个点")   # ±9.1
print(f"n=500, p=0.742 -> ±{ci95(0.742, 500):.1f} 个点")  # ±3.8
print(f"n=89, p=0.556 -> ±{ci95(0.556, 89):.1f} 个点")   # ±10.3
顺手做件更有用的事:把同一批题跑两遍,用配对样本比较(同一道题在两个模型上都过、都不过、还是一过一不过)。配对比独立比较灵敏得多,因为难度差异被题本身吸收掉了。
常见误区
- 「掉分说明模型变差了」。MaxxBench 里掉分最多的是 DeepSeek V4.1 Flash(−18.6)和 Gemini 3.8 Flash(−20.5),但没有证据说它们整体变弱,只说明它们对旧题型的适配更重。同一批模型在别的任务上未必同向变化。
- 「私有 benchmark 一定有问题」。不一定。问题在于不可复核,你只能接受结论。用它做营销可以,用它做技术选型的唯一依据不行。
- 「题越多越好」。题多解决分辨率,不解决污染。一万道被模型见过的题,精度再高也是量了个偏的量。
- 「提升 20% 就是提升了 20%」。相对提升和绝对点数经常被混着说。从 55.6 到 76.4 是 20.8 个绝对点,写成「提升 37%」也不算错,但两句话给人的判断完全不同。
本节小结
评测的产物不是一个分数,是一句带条件的话:在这 N 道题、这套判分脚本、这份算力预算下,这个模型答对了这么多。条件一改,结论就可能翻。MaxxBench 用 17 行改动做了一次压力测试,Lean 复核用四道关卡做了一次,两条路都在提醒同一件事——分数只是入口,复核才是结论。