
把模型写完的代码,当成陌生人提交的代码
模型产出代码的速度已经不是瓶颈,瓶颈在「凭什么相信这段代码」。这篇给的不是提示词技巧,而是四道闸:来源可追溯、权限最小化、测试先行、改动可回滚。核心判断只有一句——信任边界不看是谁写的,而看它在这个环境里能改什么、能碰什么。
本节你将能
读完能把「让 AI 写代码」这件已经日常化的事,翻译成一套可执行的流程:每次改动留下可追溯记录,代理拿不到不该拿的权限,测试写在改动之前而不是之后,任何一次合入都能单独撤回。目标不是不用模型,而是让它出错时你付得起代价。
直觉模型:模型输出就是外部输入
团队对「外部输入」有一套成熟的防御习惯:参数校验、边界检查、权限控制。但同一个人看到模型写出的函数,往往直接当成自己写的——因为语气像同事,格式像代码。
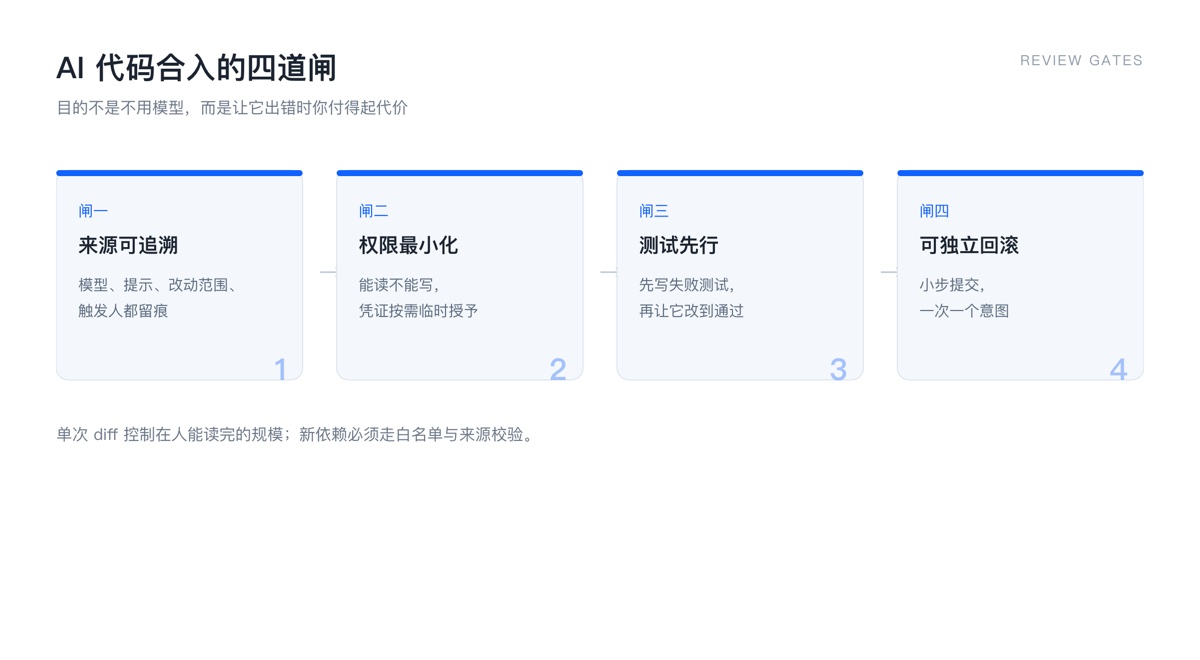
AI 代码合入的四道闸:来源可追溯、权限最小化、测试先行、可独立回滚。
把这件事想清楚只需要换个类比:模型是一个从不休息、速度极快、但完全不了解你系统的外部贡献者。它的提交和你从网上复制的一段代码,在信任级别上应该是一样的。区别只在量:外部贡献者一天提一个 PR,模型一天能提一百个。
核心要点
- 来源可追溯。每次生成留下记录:用的哪个模型、什么提示、改了哪些文件、谁触发的。出事时这份记录是唯一能还原现场的东西,也是复盘提示词与流程的依据。
- 权限最小化。代理不该直接持有生产凭证、部署密钥与数据库写权限。能读不能写、能改分支不能改主干,是最基本的划分。
- 测试先行。先写一个当前会失败的测试,再让模型把代码改到通过。顺序反了,模型很容易只为「让现有测试通过」而改,甚至悄悄放宽断言。
- 差异要可读。单次改动控制在人能认真读完的规模,几百行以内。一次几千行的 diff,评审就退化成点通过。
- 可回滚。小步提交、一次一个意图、能用开关关掉。模型改错时,回滚的成本决定了你敢不敢让它动手。
- 依赖要过闸。模型最常做的动作之一是「顺手引入一个包」。新依赖必须走白名单与来源校验,否则等于给供应链开了后门。
案例锚点
走一遍完整流程。一个问题单进来:导出报表时缺少时区转换。第一步,人写一个失败测试,断言「柏林时区的用户在夏令时切换日的导出时间正确」;第二步,把测试与相关文件给模型,要求只改这个模块;第三步,模型提交,CI 跑测试;第四步,人看 diff,重点不在「逻辑对不对」,而在「有没有动到不该动的文件、有没有新增依赖、有没有把测试放宽」;第五步,合并到一个可独立回滚的提交;第六步,上线后看指标。
这套流程里,模型的角色是「把测试从红改绿的工具」,不是「决定需求与验收标准的人」。验收标准由失败测试固定下来,模型就无法通过修改标准来「通过」。
互动
三个问题:你的代理现在能直接推送主干吗?上一次 AI 生成的改动,diff 有多少行、你读完了多少?如果明天发现某次合入引入了一个新依赖,你能在多长时间内定位它、并回滚到引入之前?
常见误区
- 以为「人审过了就安全」。审的是 diff,不是意图。模型可能在没改动的一行里依赖了某个已有配置的默认值,这类问题在 diff 里看不见。
- 以为「不碰生产就没风险」。开发环境里也常有生产数据的副本、CI 密钥与云凭证,这些正是被窃目标。
- 以为「测试通过等于行为正确」。测试是验收标准的下界。模型改测试、加跳过标记、放宽断言,都能让测试通过。
- 把「生成速度」当成「交付速度」。真正的瓶颈移到评审与验证环节,如果不在这两处扩容,产出越快,积压与风险越大。
本节小结
一句话:信任边界不看作者是谁,看它在这个环境里能改什么。四道闸——来源可追溯、权限最小化、测试先行、改动可回滚——缺一道,模型出错的代价就从「重跑一次」变成「排查两天」。
[关联推荐]
- SWE-bench:代码 Agent 到底有多能改代码 — 评测口径决定了「能用」的含义
- MCP 的信任模型 — 工具权限该划在哪一层
- 凭证是怎么从开发者的机器上流出去的 — 权限与凭证的真实事故