
2 亿参数的模型,打败了用 2000 张卡训几个月的对手

UC Berkeley 的 GPN-Star 把「物种树 + 全基因组比对」写进模型结构,用 2 亿参数、8 张 A100 训几天,在编码区与非编码区的变异效应预测上都刷新了纪录。对照对象是 128 张 A100 训一个月的 Nucleotide Transformer,和 2000 多张 H200 训几个月的 Evo-2。论文 2026 年 9 月 9 日发在《自然》。
基因组语言模型的困境很具体:人类基因组 30 亿个碱基,只有 1% 到 2% 编码蛋白质,其余是非编码的调控序列和「垃圾 DNA」。癌症、心脏病、自闭症相关的变异大量落在非编码区,但这里没有密码子表可依,模型只能从序列里自己学规律。前几年的做法是把 DNA 当文本,堆参数、堆语料,效果却常常不如上世纪就成型的进化保守性模型。
GPN-Star 换了个入口:不把序列当纯文本,而是喂进「比对」。团队用以人为锚点的全基因组比对(WGA),分三个进化尺度——只含灵长类、含哺乳动物、含更广的脊椎动物。比对本身已经把「哪些位点在进化中被保留、哪些可以随便变」筛过一遍,等于把生物学先验直接写进了输入。模型结构里再加入物种树,显式建模亲缘关系。
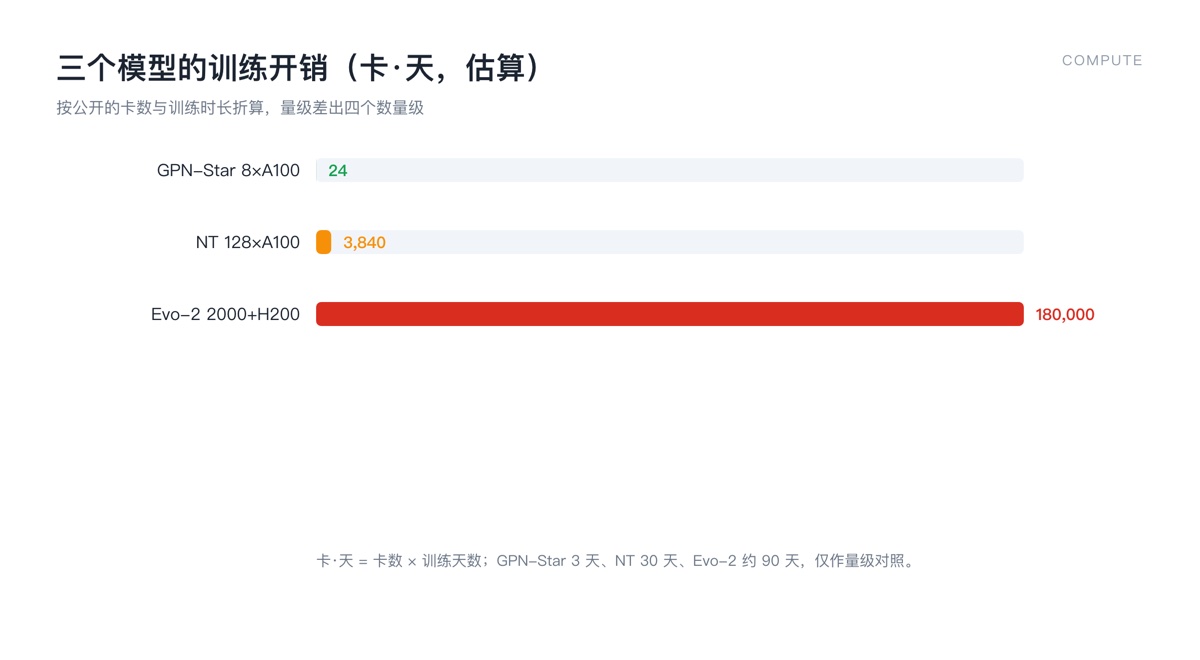
三个模型的训练开销对比(卡·天,按公开数据折算)。
规模上,主模型 2 亿参数,8 张 A100 训几天。对照:Nucleotide Transformer 用 128 张 A100 训一个月;Evo-2 用 2000 多张 H200 训几个月,语料覆盖 10 万多个物种。算力差两个数量级,效果反而更好,这是这篇论文最值得记的一点——它说明这类任务的瓶颈不在参数,在归纳偏置。
结果层面有三条比较硬。其一,致病变异优先级排序显著优于既有方法,在 ClinVar 等临床数据库与实验功能测定上都是最好一档。其二,全基因组关联分析(GWAS)信号的精细定位更强,复杂性状遗传力的富集度更高,罕见变异关联检验的统计功效也有提升。其三,团队为全部约 90 亿个可能的单核苷酸变异给出了预计算分数——这个规模让「先算后查」成为可能,而不是每来一个变异就重跑模型。
进化尺度的差异也很有意思,而且是任务相关的:长尺度(脊椎动物)比对更擅长判断蛋白质里的罕见变异,这类位点进化慢、跨物种保守;短尺度(灵长类)比对更擅长判断复杂性状相关的非编码变异,比如精神分裂症风险涉及的大量调控位点。同一套框架,换比对深度就换了一种「视角」,这个发现比单点指标更有方法论价值。
可迁移性也做了验证:小鼠、鸡、果蝇、秀丽隐杆线虫、拟南芥五个模式生物各训一个模型,框架照样成立。代码与预计算分数已开源发布,其他实验室可以直接拿去用。
边界要写清。第一,它是研究工具,不是诊断工具:临床解读还需要独立验证与专业判断,论文自己也这么标注。第二,预计算分数覆盖的是单核苷酸替换,插入、缺失、结构变异不在其中。第三,比对质量决定上限:比对里缺失的类群、组装质量差的区域,模型同样看不见。第四,效果提升集中在「排序」这类任务,不等于能预测表型。
这篇工作的真正提示是:当算力堆到边际收益递减时,把领域知识写进输入结构,往往比再加一倍参数更有效。这个判断不只适用于基因组,也适用于很多「有大语料但缺归纳偏置」的领域。
[关联推荐]
- AI 翻遍 2.14 亿个蛋白质形状,捞出人体中一个「隐形」蛋白 — 大规模预计算 + 筛选的同类思路
- AI 不再只是预测蛋白质,它开始用大白话「写」出能用的蛋白 — 从预测到生成的下一步
来源:UC Berkeley CDSS 报道(2026-09-09);GPN-Star 论文全文(PMC);对照模型算力数据见论文 Methods 与 Artificial Science 综述(2026-09-12)。
评论 (0)
正文划词可点「问萝卜特」——自动发评论并由 AI 回复
加载评论中…