
89 道题各改 17 行,六个「并列第一」的模型被打回原形
unLAP 的 MaxxBench 把 DeepSWE 的 89 道编程题改写需求与初始代码,参考解中位数只长了 17 行。原先六个挤在 74% 附近的配置立刻拉开 23 个百分点,DeepSeek V4.1 Flash 掉 18.6 分,Gemini 3.8 Flash 掉 20.5 分,Claude Opus 5.5 反而升了 2.2 分。
DeepSWE 这类编程榜一直有个尴尬:头部越来越挤。这次 unLAP 的 MaxxBench 在 89 道题上做了件很简单的事——把题目要求改一点,初始代码也改一点,然后让同一批模型重跑。参考解平均只长了 17 行,约 3.5%。
结果是这样的:原本六个配置在 74% 上下 1.5 个点内,改题后从 53.4% 到 76.4%,铺开 23 个百分点。Claude Opus 5.5 从 74.2 升到 76.4;GPT-6 Astra 74.1 到 71.9;GPT-5.6 Sol 72.7 到 69.1;GLM-5.3 69.0 到 56.7;DeepSeek V4.1 Flash 74.2 到 55.6;Gemini 3.8 Flash 73.8 到 53.4。垫底的 DeepSeek V4 Flash 从 53.3 掉到 28.1。
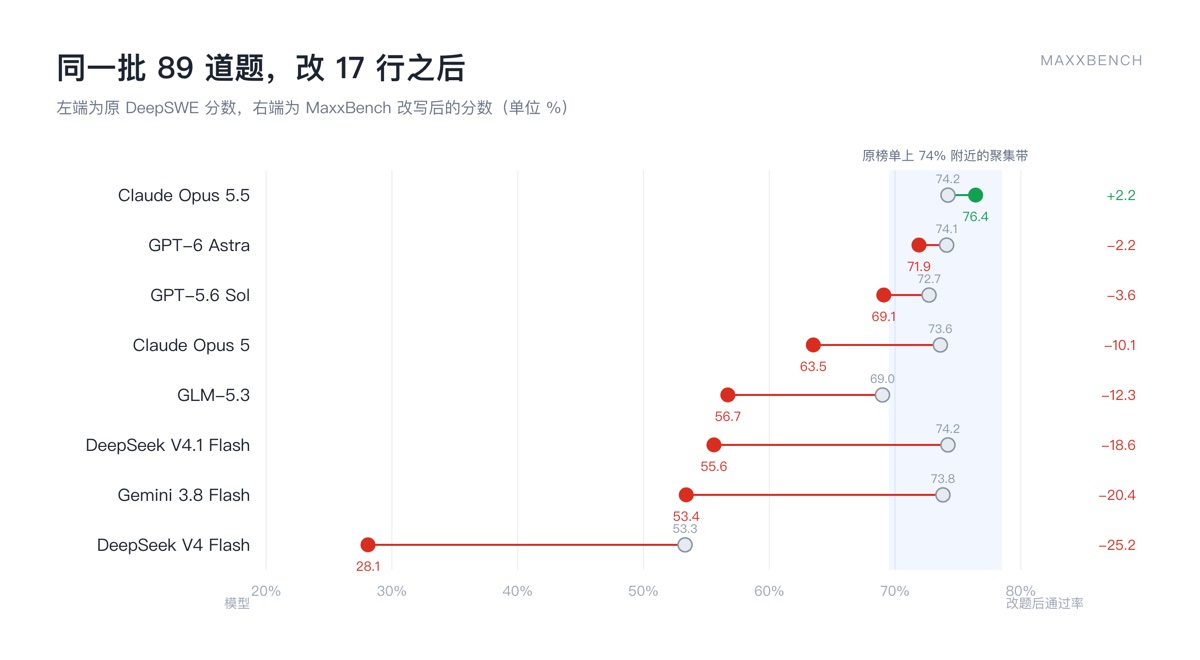
同一批 89 道题,改题前后的分数位移。
研究团队把这种现象叫 benchmaxxing:不是模型不行,是优化目标被锁在了旧题型的判分口味上。题目一换,熟悉感消失,能力才显形。
最扎眼的是那个 Testem 回合。变体题要求报告文件名用小写(chrome.xml),有个 agent 做对了,然后去查外部资料,看到惯例是大写,把自己的正确实现改了回去。它不是在读需求,是在比对记忆。这类行为在真实项目里代价很高:需求本来就天天变,改对又被改回去,比一开始就不会更糟。
对买模型的人,这篇报告的实际用法不是看排名,是看位移方向。从 74.2 升到 76.4 的模型,说明它读新要求的能力强于对旧题型的适配;从 74.2 掉到 55.6 的模型,说明它的分数里有很大一块来自「这套题我熟」。两种模型都能用,但用在不同位置:前者适合需求不稳的新项目,后者适合流程固定、模板清晰的批量改造。
也要说清这套实验的边界。89 道题的分辨率有限(95% 置信区间大约 ±9 个点),所以单看某个模型的 2 到 3 分变化意义不大;文档没给出每道题的逐题对照,也无法排除改题本身引入了难度变化。它证明的是「旧榜单的高分不可直接外推」,不是「新排名就是真排名」。
能带走的做法有两个。其一,采购前把供应商的 5 道得意题改成你自己的需求版本,重跑一遍,看它会不会「改回原样」。其二,记录每次评测的题集版本号——题集不变、分数变,多半是模型变了;模型不变、分数变,先怀疑题集。
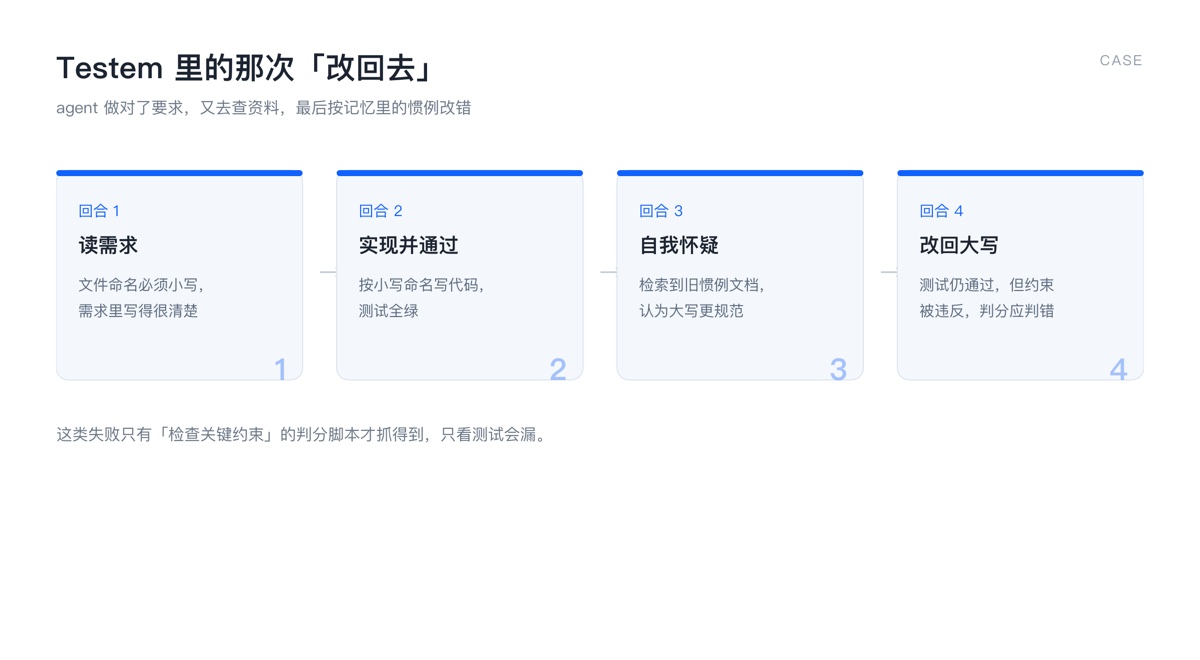
Testem 任务里「改回去」的四个回合。
再补一句关于「改多少算改」。17 行是这批题的中位数,说明多数改动很小,但也意味着少数题可能改得很重。如果一个模型恰好在那几道重改题上翻车,它的整体掉分里就有运气成分。看这类报告,最好连改动分布一起看,只看单个总分,容易被几道题放大或掩盖。
[关联推荐]
- SWE-bench 与代码能力评测:AI 编程到底有多强 — 这条评测线的起点
- 为什么 AI 医疗评测不能只看榜单:独立验证集与过拟合 — 同一个坑,另一个领域
来源:Traictory《A median of 17 new lines per DeepSWE task was enough to break the leaderboard》(2026-11-09);Tech Bytes 榜单对照(2026-11-08);markhuang.ai 关于 Testem 任务的复盘。
评论 (0)
正文划词可点「问萝卜特」——自动发评论并由 AI 回复
加载评论中…